
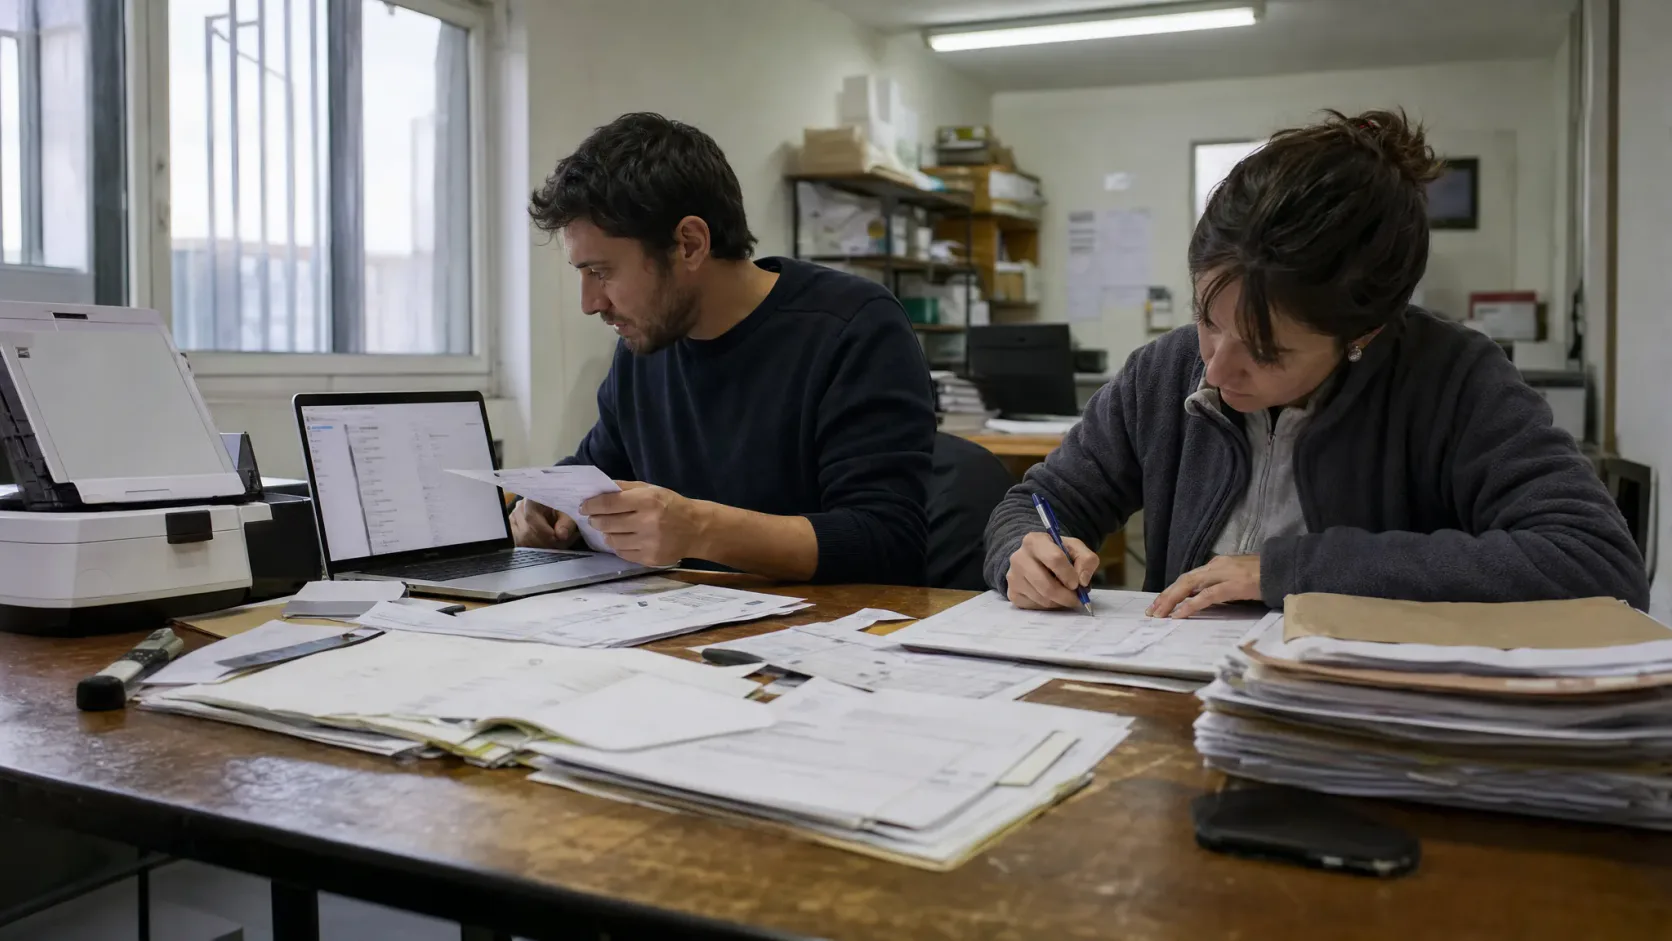
Lundi matin, une facture arrive par e-mail, une autre via le portail d’un fournisseur, et une troisième est accompagnée d’un bon de livraison qui ne correspond pas à la commande. Sur le tableau de bord, tout paraît propre : documents reçus, traitement en cours, aucune incidence ouverte. Mais au service comptable, quelqu’un fait l’inverse de ce que montre le dashboard : copier des données, comparer des montants, retrouver la bonne commande et appeler les achats pour clarifier une ligne douteuse.
Le problème n’est pas de recevoir plus de documents ; c’est de décider quelle erreur coûte peu et laquelle coûte cher.
Ma thèse est simple : automatiser les factures avec l’IA ne consiste pas à supprimer des personnes, mais à séparer la classification, l’extraction et la validation selon le coût de l’erreur. Quand une entreprise mélange ces trois étapes, elle fabrique un système qui semble moderne mais ne fait que déplacer le travail ailleurs.
La scène que l’indicateur ne montre pas
Dans beaucoup de PME, le vrai flux de facture commence avant la facture elle-même. Il démarre quand un fournisseur envoie un fichier dans un format différent, quand les achats acceptent une exception, ou quand un opérateur d’entrepôt confirme une livraison partielle. Chacun de ces gestes laisse une trace différente, mais le système demande souvent une seule réponse : valider ou rejeter.
C’est là que la friction entre équipes apparaît. La finance veut de la précision. Les achats veulent de la vitesse. Les opérations veulent qu’on ne rouvre pas ce qui semblait déjà clos. Le résultat est une boucle d’e-mails et de petites décisions qui n’apparaît jamais dans le tableau de bord, parce que personne ne la mesure comme un coût de coordination.
L’IA aide vraiment quand elle réduit ce travail invisible. Pas quand elle promet un miracle.
Trois tâches, trois niveaux de risque
Il est utile de séparer le flux en trois couches :
- Classer : savoir si le document est une facture, un avoir, un bon de livraison ou un reçu. Ici, une certaine marge d’erreur peut être acceptable si la vérification derrière est peu coûteuse.
- Extraire : lire le numéro fiscal, le numéro de facture, le montant hors taxes, la TVA, l’échéance, la commande associée et d’autres champs. Ici, la précision compte, mais aussi la cohérence : une donnée mal captée peut casser un rapprochement.
- Valider : décider si le document passe, s’il est bloqué ou s’il doit être revu par un humain. C’est la partie la plus sensible, car elle touche à la trésorerie et à la relation fournisseur.
L’idée clé est d’utiliser des seuils différents. Il n’a aucun sens de demander une revue humaine pour tout ce dont le modèle n’est “que” sûr à 88 % si la correction prend cinq secondes. Il n’a pas plus de sens de laisser passer une petite divergence sur une facture qui peut doubler un paiement ou masquer un mauvais débit.
OpenAI rappelle justement que le passage à l’échelle de l’IA ne repose pas seulement sur le déploiement, mais sur la confiance, la gouvernance et des flux de travail où la supervision humaine reste pertinente. (openai.com)
L’erreur inconfortable : automatiser l’exception avant la norme
Voici la tentation risquée. Beaucoup d’entreprises commencent par le cas le plus bruyant : factures très variables, fournisseurs compliqués ou documents qui “posent toujours problème”. Cela paraît logique parce que la douleur est visible. En réalité, c’est souvent le pire point de départ.
Pourquoi ? Parce que l’exception apporte de la variété mais peu de répétition. L’IA, surtout au début, apprend mieux là où il y a du schéma, du volume et des règles métier claires. Si vous démarrez dans le chaos, vous risquez d’obtenir un outil coûteux qui ne produit qu’une revue manuelle plus sophistiquée.
Un cas composite l’illustre bien : une entreprise industrielle avec achats centralisés a voulu automatiser d’un coup toute l’entrée des factures. Le projet s’est bloqué parce que chaque service utilisait des critères différents pour traiter les écarts. Quand elle a séparé le flux en trois groupes — factures standard, factures avec commande et factures avec écart — l’adoption a progressé. Pas parce que l’IA avait changé, mais parce que l’entreprise n’exigeait plus d’elle une décision unique pour trois problèmes différents.
Ce que la direction devrait mesurer avant d’élargir
Si vous vouliez tester cette approche sans lancer un grand programme, vous ne regarderiez pas seulement le pourcentage de documents traités. Vous observeriez des signaux plus utiles :
- combien de factures arrivent sans ressaisie manuelle ;
- à quel moment la revue humaine s’arrête et pourquoi ;
- combien de temps prend la résolution d’une exception, de l’entrée à la clôture ;
- combien de fois un fournisseur doit renvoyer le même document ;
- combien d’écarts sont de vrais sujets métier et combien relèvent du bruit du processus.
Cela change la conversation. On cesse de demander “l’IA est-elle juste ?” et on commence à demander “quel travail enlève-t-elle, et quel travail déplace-t-elle ?”. C’est la différence entre automatiser et simplement cacher la friction.
Un petit test, réversible et utile
Pas besoin d’un grand programme pour apprendre. Cette semaine, vous pouvez tester quelque chose de plus modeste :
- prendre un seul type de document, par exemple les factures de fournisseurs récurrents ;
- définir trois sorties : automatique, revue humaine et blocage ;
- fixer des seuils de confiance différents selon les champs critiques ;
- revoir manuellement seulement un échantillon des cas douteux ;
- mesurer le temps gagné et les nouveaux types d’erreurs.
Si le test fonctionne, vous aurez gagné en discernement. S’il échoue, vous aurez appris où se trouve le vrai coût sans mettre toute l’opération en risque.
La question n’est pas de savoir si l’IA peut lire une facture. La question est de savoir si votre entreprise est prête à décider quelle revue doit rester humaine et laquelle alimente seulement la bureaucratie. Qu’est-ce que vous feriez vérifier moins souvent si vous pouviez davantage faire confiance à la première classification ?
Chez Codefuente, nous commençons souvent exactement là : au point où le processus réel et le tableau de bord racontent deux histoires différentes, parce que c’est là que l’automatisation cesse d’être une promesse et devient une opération.