
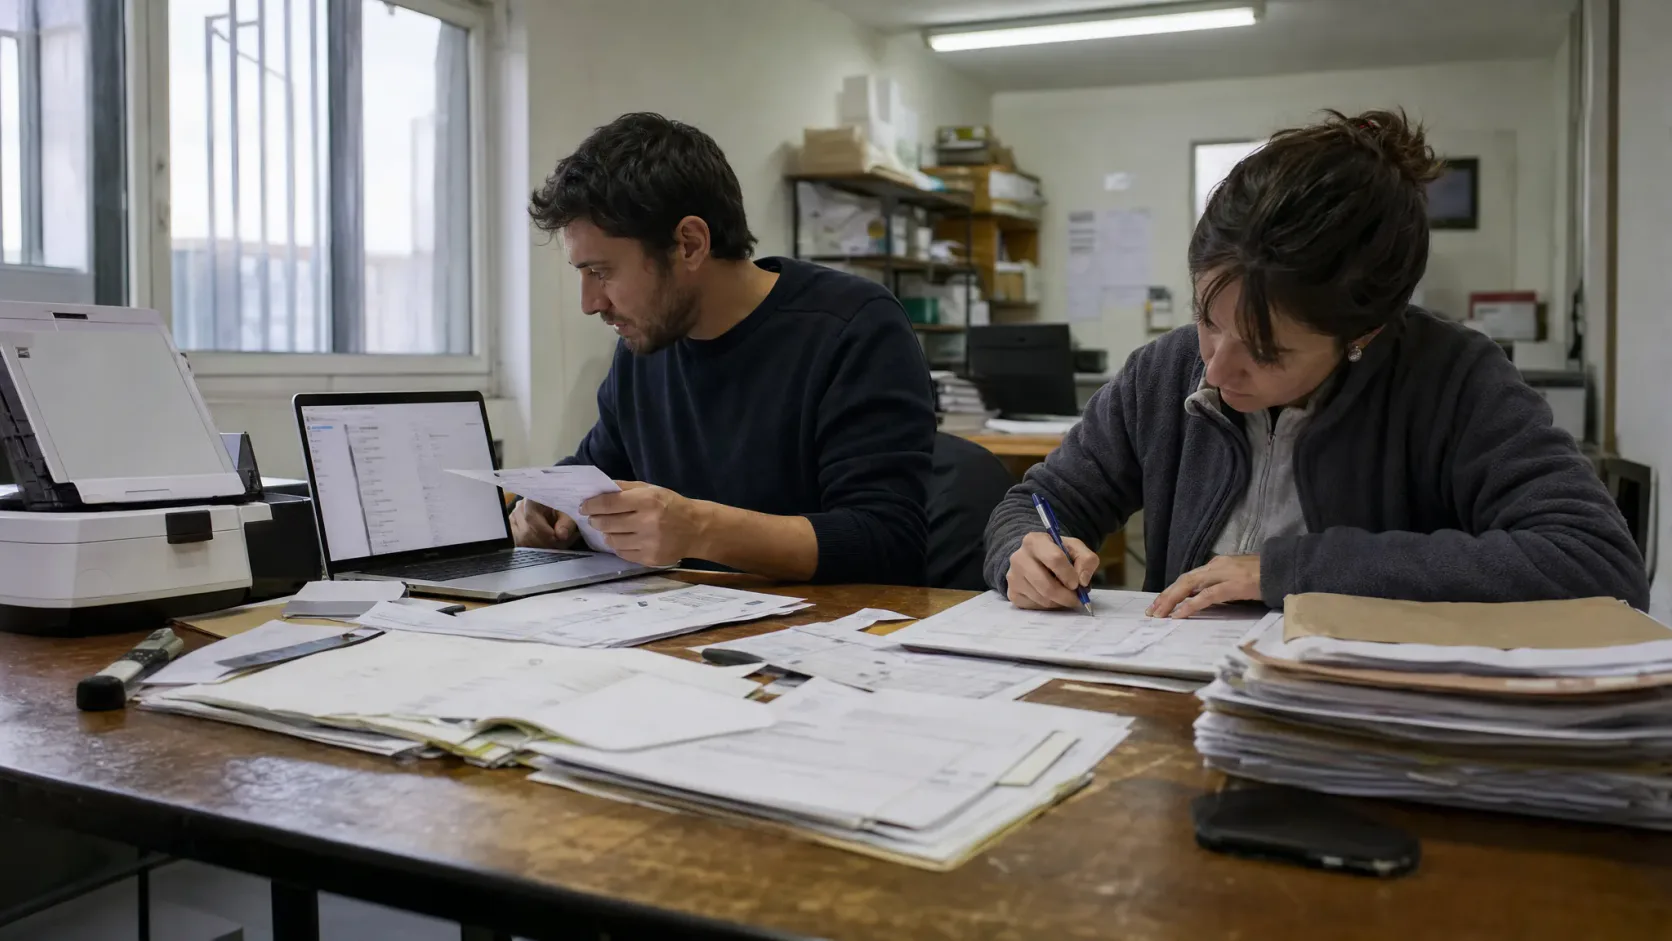
El lunes por la mañana, una factura entra por correo, otra por portal de proveedor y una tercera llega con un albarán que no cuadra. En el dashboard todo parece limpio: documentos recibidos, proceso en marcha, cero incidencias abiertas. Pero en la mesa de cuentas a pagar alguien está haciendo justo lo contrario de lo que promete el cuadro de mando: copiar datos, comparar importes, buscar el pedido correcto y llamar a compras para aclarar una línea dudosa.
El problema no es recibir más documentos; es decidir qué error cuesta poco y cuál cuesta caro.
Mi tesis es sencilla: automatizar facturas con IA no consiste en “quitar personas”, sino en separar la clasificación, la extracción y la validación según el coste del error. Cuando una empresa mezcla esas tres cosas, crea un sistema que parece moderno y en realidad solo traslada trabajo a otro sitio.
La escena que el KPI no enseña
En muchas pymes, el flujo real de una factura empieza antes de la factura. Comienza cuando el proveedor envía un archivo con formato distinto, cuando compras negocia una excepción, o cuando un operario de almacén valida una entrega incompleta. Cada uno de esos gestos deja una huella distinta en el documento, pero el sistema suele pedir una sola respuesta: “aprobar” o “rechazar”.
Ahí aparece la fricción entre equipos. Finanzas quiere exactitud. Compras quiere velocidad. Operaciones quiere que nadie le haga volver a mirar lo ya cerrado. El resultado es un circuito de correos y mini-decisiones que no aparece en el dashboard porque nadie lo mide como coste de coordinación.
La IA ayuda de verdad cuando reduce ese trabajo invisible. No cuando promete magia.
Tres tareas, tres niveles de riesgo
Conviene separar el flujo en tres capas:
- Clasificar: saber si un documento es factura, abono, albarán o justificante. Aquí el margen de error puede ser aceptable si la revisión posterior es barata.
- Extraer: leer NIF, número de factura, base imponible, IVA, vencimiento, pedido asociado y otros campos. Aquí importa la precisión, pero también la consistencia: un dato mal capturado puede romper una conciliación.
- Validar: decidir si el documento pasa, si se bloquea o si necesita revisión humana. Esta es la parte más sensible porque afecta al dinero y a la relación con el proveedor.
La clave está en usar umbrales distintos. No tiene sentido pedir revisión humana a todo lo que el modelo duda un 12% si corregirlo cuesta cinco segundos, ni tampoco dejar pasar una discrepancia pequeña en una factura que puede duplicar un pago o ocultar un cargo incorrecto.
OpenAI resume bien esta idea al recordar que escalar IA no va solo de implantar tecnología, sino de crear confianza, gobernanza y un flujo de trabajo donde la supervisión humana siga teniendo sentido. (openai.com)
El error incómodo: automatizar la excepción antes que la norma
Aquí está la tentación peligrosa. Muchas empresas empiezan por el caso más ruidoso: facturas con muchos formatos, proveedores conflictivos o documentos que “siempre dan guerra”. Parece lógico porque el dolor es visible. En realidad, suele ser el peor sitio para empezar.
¿Por qué? Porque la excepción trae mucha variedad y poca repetición. Y la IA, sobre todo al principio, aprende mejor donde hay patrón, volumen y reglas de negocio claras. Si arrancas por el caos, puedes acabar con una herramienta cara que solo genera revisiones manuales más sofisticadas.
Un caso compuesto lo ilustra bien: una empresa industrial con compras centralizadas quiso automatizar toda la entrada de facturas de golpe. El proyecto se atascó porque cada departamento usaba criterios distintos para validar incidencias. Cuando dividieron el flujo en tres grupos —facturas estándar, facturas con pedido y facturas con discrepancia—, la adopción mejoró. No porque la IA fuese distinta, sino porque el negocio dejó de pedirle una decisión única para problemas diferentes.
Qué debería medir una dirección antes de escalar
Si hoy quisieras probar este enfoque sin montar un programa grande, no mirarías solo el porcentaje de documentos procesados. Mirarías señales más útiles:
- cuántas facturas llegan sin tener que reescribir campos a mano;
- en qué punto se detiene la revisión humana y por qué;
- cuánto tarda una incidencia en resolverse desde que entra hasta que se cierra;
- cuántas veces un proveedor tiene que reenviar el mismo documento;
- cuántas excepciones son realmente de negocio y cuántas son ruido del proceso.
Eso cambia la conversación. Dejas de preguntar “¿la IA acierta?” y empiezas a preguntar “¿qué trabajo elimina y qué trabajo desplaza?”. Esa es la diferencia entre automatizar y solo ocultar fricción.
Un experimento pequeño, reversible y útil
No hace falta un gran programa para aprender. Esta semana puedes probar algo más modesto:
- tomar un solo tipo de documento, por ejemplo facturas de proveedor recurrente;
- definir tres salidas: automática, revisión humana y bloqueo;
- fijar un umbral de confianza distinto para cada campo crítico;
- revisar manualmente solo una muestra de los casos dudosos;
- medir cuánto tiempo ahorra y qué errores nuevos aparecen.
Si el experimento funciona, habrás ganado criterio. Si no funciona, habrás aprendido dónde está el coste real sin comprometer toda la operación.
La pregunta no es si la IA puede leer una factura. La pregunta es si tu empresa está preparada para decidir qué revisión merece ser humana y cuál solo está alimentando burocracia. ¿Qué documento revisarías menos si pudieras confiar más en la clasificación inicial?
En Codefuente solemos empezar justo ahí: en el punto donde el proceso real y el cuadro de mando cuentan historias distintas, porque ahí es donde la automatización deja de ser promesa y empieza a ser operación.