Une entreprise ne découvre pas l’éthique de l’IA dans un laboratoire. Elle la découvre un lundi, quand un client se plaint, qu’un candidat reçoit une mauvaise réponse ou qu’une équipe valide une décision que personne n’a vraiment relue.
Le débat utile n’est pas « utiliser ou non l’IA », mais « quelles décisions peut-elle prendre seule, et lesquelles non ».
Ma thèse est simple : dans une entreprise sérieuse, l’IA ne devrait pas décider seule sur des personnes, de l’argent ou l’accès à un service lorsque le coût de l’erreur est élevé. Elle peut accélérer, trier ou prioriser. Mais si la décision a un effet réel, il faut une revue humaine, des critères documentés et un moyen clair de corriger.
Le cas réaliste qui force la discussion
Imaginons une PME de services de 40 personnes. Elle veut utiliser l’IA pour classer les demandes clients, prioriser les incidents et pré-filtrer les candidatures. Sur le papier, l’idée paraît logique : réponse plus rapide, moins de travail manuel et plus d’ordre. En pratique, trois questions dérangeantes apparaissent.
La première est la vie privée. Quelles données entrent réellement dans le système ? A-t-on besoin de tout, ou nourrit-on l’outil avec des informations inutiles pour la décision ? La deuxième est le biais : si le modèle apprend à partir de décisions passées, il peut recopier les erreurs anciennes et les présenter comme de l’efficacité. La troisième est la responsabilité : quand une décision tourne mal, qui répond, qui la vérifie et comment la corrige-t-on ?
Ici, il faut distinguer clairement l’obligation juridique et la bonne pratique. Le droit applicable impose la protection des données, la transparence et, selon l’usage, des obligations spécifiques du cadre européen sur l’IA. Mais l’entreprise peut choisir d’être plus prudente que le minimum légal : limiter les données, envoyer les cas incertains en revue et enregistrer pourquoi une recommandation a été acceptée ou refusée.
Vie privée : moins de données, meilleur jugement
Dans la plupart des processus, l’erreur n’est pas « trop de données » en soi. L’erreur, c’est de ne pas savoir à quoi sert chaque champ. Si une classification peut se faire avec le type de demande et l’historique opérationnel, rien ne justifie d’ajouter des champs sensibles ou des informations sans valeur décisionnelle. Moins d’entrées signifie souvent moins d’exposition et moins de bruit, pas une moins bonne décision.
La question pratique est simple : si quelqu’un conteste une décision demain, pouvons-nous reconstituer ce que le système a vu et pourquoi il a produit cette sortie ? Si la réponse est non, le problème est la traçabilité, pas le modèle.
Le cadre de NIST sur les risques de l’IA insiste sur une gestion systématique du risque tout au long du cycle de vie, avec une logique de gouvernance, cartographie, mesure et gestion. Par ailleurs, l’Union européenne applique déjà son AI Act dans son calendrier actuel, avec des obligations qui dépendent du cas d’usage et du niveau de risque. En clair, une entreprise ne devrait pas traiter l’IA comme une simple application bureautique. (nist.gov)
Biais : le problème n’est pas toujours l’algorithme
Un biais n’apparaît pas seulement parce que le modèle est « mauvais ». Il apparaît très souvent parce que les données d’entrée reflètent des décisions passées, des exceptions mal enregistrées ou des critères qui n’ont jamais été homogènes. Si les ventes, le support ou les RH travaillaient déjà avec des règles inégales, l’IA peut transformer cette incohérence en vitesse, pas en amélioration.
C’est pourquoi trois signaux opérationnels comptent : des écarts systématiques entre groupes comparables, des cas que le modèle classe avec une faible confiance et des erreurs répétées aux mêmes étapes du processus. Sans cela, nous n’avons que des impressions. Et les impressions coûtent cher quand le système monte en charge.
L’Agence espagnole de protection des données rappelle aussi que l’IA ne supprime ni les obligations de confidentialité ni l’analyse des biais liés à la qualité des données. En termes simples : la responsabilité ne disparaît pas parce qu’une machine a suggéré la décision. (aepd.es)
La décision inconfortable : laisser intervenir un vrai humain
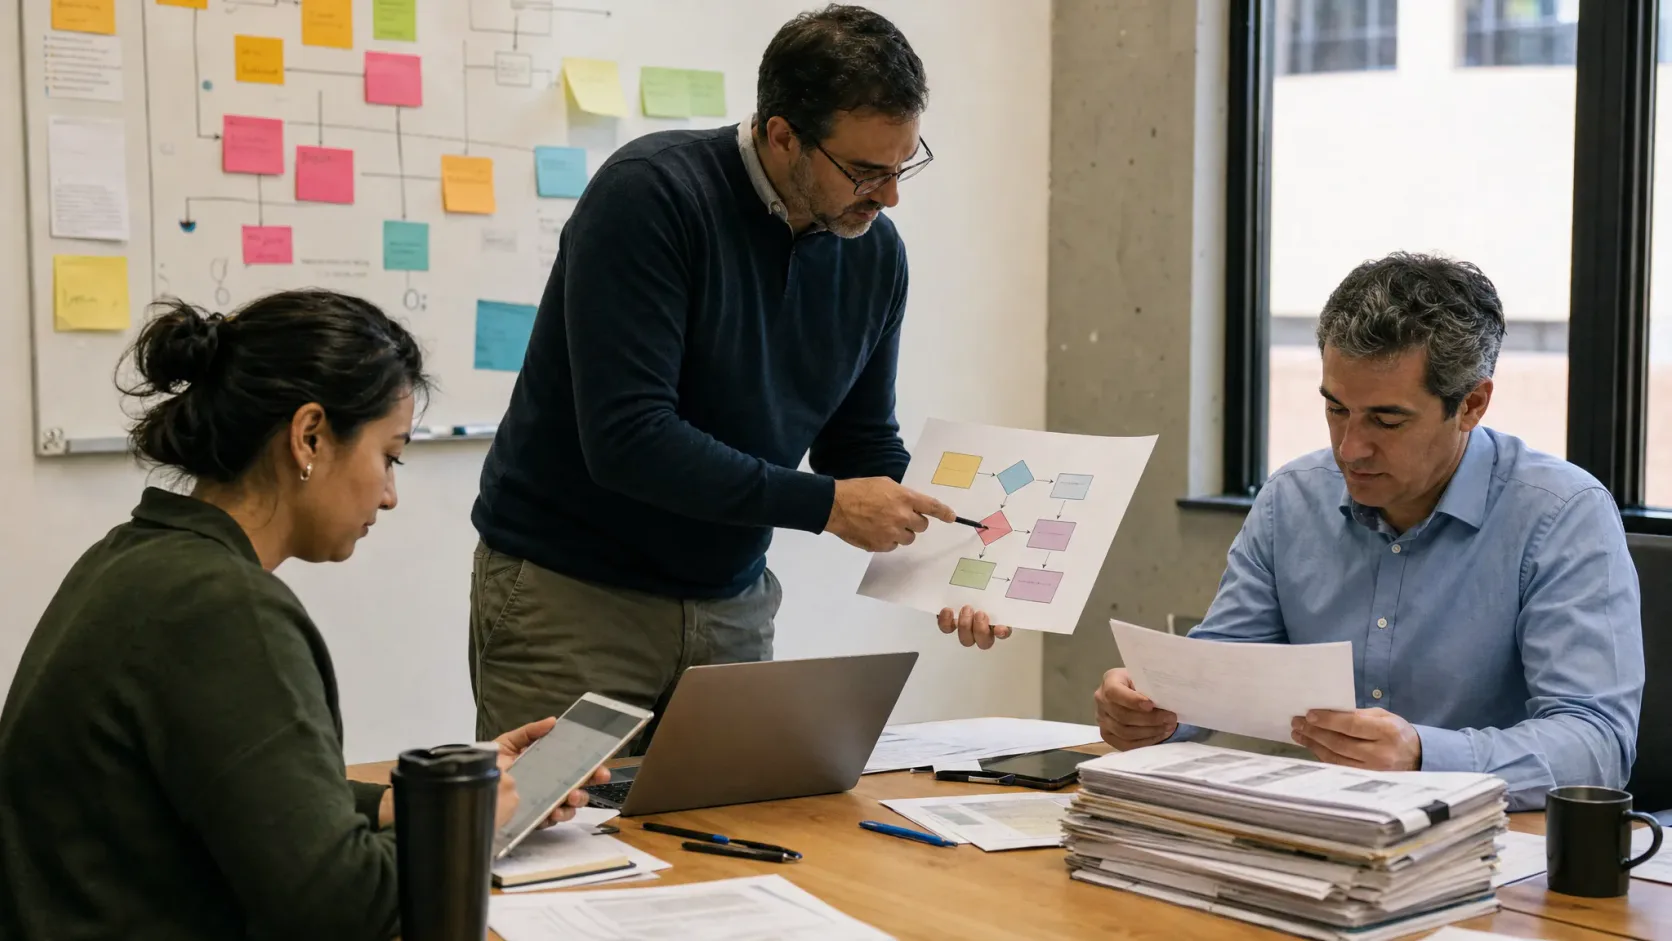
Voici la partie la moins confortable pour beaucoup d’organisations : la revue humaine ne peut pas être décorative. Il ne suffit pas qu’une personne clique sur « valider » après que le système a déjà orienté le dossier. Le relecteur doit avoir du temps, du contexte et un vrai pouvoir de changer l’issue.
Cela modifie le design du processus. Cela peut vouloir dire moins d’automatisation totale et plus de file de revue. Cela peut aussi vouloir dire accepter un traitement un peu plus lent pour les cas sensibles afin d’éviter une erreur coûteuse. Et cela peut signifier renoncer à la promesse brillante du « tout automatique » au profit d’un modèle moins spectaculaire, mais beaucoup plus défendable.
La bonne mesure n’est pas le nombre de cas traités par l’IA. C’est le nombre de cas corrigés, expliqués et transformés en réclamation. Si le système accélère le travail mais augmente les litiges, l’entreprise n’a pas gagné en efficacité ; elle a déplacé le problème.
Ce qu’il faut mesurer pour savoir si cela fonctionne vraiment
Trois métriques suffisent pour démarrer sans transformer le projet en bureaucratie :
- pourcentage de décisions sensibles relues par une personne ;
- taux de correction ou d’inversion des recommandations de l’IA ;
- nombre d’incidents, réclamations ou exceptions liés au processus.
Ensuite, ajoutez une question : pouvons-nous auditer une décision en une semaine, pas en un mois ? Si la réponse est oui, le système devient réellement opérable.
Trois questions pour cette semaine
- Quelles décisions de votre entreprise ne devraient jamais être prises par l’IA sans revue humaine ?
- Savez-vous quelles données chaque processus automatisé utilise aujourd’hui, et lesquelles sont inutiles ?
- Votre équipe peut-elle expliquer une décision contestée avec des preuves, pas avec une intuition ?
Si votre organisation veut utiliser l’IA avec prudence, l’objectif n’est pas de freiner l’adoption. C’est de lui donner des limites claires. Chez Codefuente, c’est souvent là que la discussion devrait commencer : moins de promesses, plus de jugement, et un processus capable de survivre à un audit, à une réclamation et à un lundi ordinaire.